我们一直着眼于网络模型的线性回归部分,而暂时忽略了 M-P 神经元模型中激活函数的部分。
理论上,如果只是线性回归的话,无论多少层的网络模型仍然还是线性变换,并不会和单层网络模型有本质的差别。这也正是我们在上一个章节观察到的现象。
💡 提示:根据通用近似定理(Universal Approximation Theorem),数学证明,一定条件下,一个包含至少一个隐藏层和非线性激活函数的网络模型,可以以任意精度逼近任意连续函数。
要让神经网络真正强大,必须引入非线性(Nonlinear)。这就是激活函数(Activation Function)可以起到的作用。在线性层之间使用激活函数,可以使网络模型不再局限在线性模型,从而能够学习到输入与输出之间更复杂的关系。
激活函数是人工神经元的一部分。但是在深度学习的实践中,通常都是被设计成单独的一层,和线性层配合使用。
from abc import ABC, abstractmethod

import numpy as npnp.random.seed(42)张量
class Tensor:

    def __init__(self, data):
        self.data = np.array(data)
        self.grad = np.zeros_like(self.data)
        self.gradient_fn = None
        self.parents = set()

    def backward(self):
        if self.gradient_fn is not None:
            self.gradient_fn()

        for p in self.parents:
            p.backward()

    def __str__(self):
return f'Tensor({self.data})'数据集
class Dataset:

    def __init__(self, batch_size=1):
        self.batch_size = batch_size
        self.load()
        self.train()

    def load(self):
        self.train_data = ([[22.5, 72.0],
                            [31.4, 45.0],
                            [19.8, 85.0],
                            [27.6, 63.0]],
                           [[95],
                            [210],
                            [70],
                            [155]])
        self.test_data = ([[28.1, 58.0]],
                          [[165]])

    def train(self):
        self.data = self.train_data

    def eval(self):
        self.data = self.test_data

    def all(self):
        x, y = self.data
        return Tensor(x), Tensor(y)

    def __len__(self):
        x, *_ = self.data
        return len(x) // self.batch_size

    def __getitem__(self, index):
        s = slice(index * self.batch_size, (index + 1) * self.batch_size)
        x, y = self.data
return Tensor(x[s]), Tensor(y[s])class Layer(ABC):
def __call__(self, x: Tensor):
return self.forward(x)
@abstractmethod
def forward(self, x: Tensor):
pass
@property
def parameters(self):
return []线性层
class Linear(Layer):

    def __init__(self, in_size, out_size):
        self.weight = Tensor(np.random.randn(out_size, in_size) * np.sqrt(2 / in_size))
        self.bias = Tensor(np.zeros(out_size))

    def forward(self, x: Tensor):
        p = Tensor(x.data @ self.weight.data.T + self.bias.data)

        def gradient_fn():
            self.weight.grad += p.grad.T @ x.data
            self.bias.grad += np.sum(p.grad, axis=0)
            x.grad += p.grad @ self.weight.data

        p.gradient_fn = gradient_fn
        p.parents = [x]
        return p

    @property
    def parameters(self):
return [self.weight, self.bias]顺序层
class Sequential(Layer):

    def __init__(self, layers):
        self.layers = layers

    def forward(self, x: Tensor):
        for l in self.layers:
            x = l(x)
        return x

    @property
    def parameters(self):
return [p for l in self.layers for p in l.parameters]激活函数
线性整流函数(ReLU)
线性整流函数(Rectified Linear Unit,ReLU)是目前最常用的中间隐藏层激活函数。它的逻辑非常简单:负数归零。
ReLU 激活函数优点非常明显:
计算高效,仅需阈值操作;
过滤掉所有负数。可以理解为过滤掉所有不重要的信息,或者噪音;
所有正数保持不变,在正数区间的导数恒为 1。因此不会减弱有效信息,避免了梯度消失。这对于训练深层网络至关重要。
前向传播:负数清零。
梯度计算:正数保留梯度。ReLU 激活函数的导数为:
父节点列表(parents):输入值。
参数列表(parameters):无,没有需要训练的参数。
class ReLU(Layer):

    def forward(self, x: Tensor):
        # 创建激活值张量
        a = Tensor(np.maximum(0, x.data))

        # 激活值张量的梯度(闭包)函数
        def gradient_fn():
            x.grad += a.grad * (a.data > 0)

        a.gradient_fn = gradient_fn
        # 激活值张量的父节点列表
        a.parents = [x]
        return a
我们看一下 ReLU 激活函数的效果:
import matplotlib.pyplot as plt

relu = ReLU()

plt.figure(figsize=(5, 3))
x_range = np.arange(-10, 10, 0.1)
plt.plot(x_range, [relu(Tensor(x)).data for x in x_range], linewidth=2)
plt.xlabel('x', fontsize=12)
plt.ylabel('y', fontsize=12)
plt.title('ReLU', fontsize=14, fontweight='bold')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()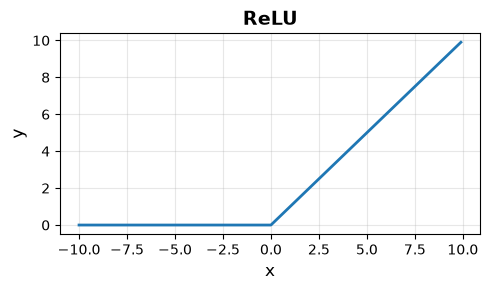
双曲正切函数(Tanh)
双曲正切函数(Hyperbolic Tangent,Tanh)可以将任何数值映射到 的范围内,同时保持数值之间的相对关系。可以用来消除“曝光过度”造成的极端数值,使数据分布在零点附近。和 ReLU 激活函数一样,常用于中间隐藏层。
前向传播:双曲正切,将输入值映射到 范围内。输出值零中心化(均值为 0)。我们直接调用 NumPy 提供的 tanh 函数来计算。
梯度计算:Tanh 激活函数的导数可以用其自身来表达。这意味着我们不需要重新计算复杂的指数函数。Tanh 激活函数的导数为:
当输入值很大、或者很小的时候,导数会趋近于 0。这就是我们常说的梯度饱和(Gradient Saturation)现象。在深层网络中,这会导致传回来的信号越来越弱,最终引发梯度消失。
父节点列表(parents):输入值。
参数列表(parameters):无。
class Tanh(Layer):

    def forward(self, x: Tensor):
        # 创建激活值张量
        a = Tensor(np.tanh(x.data))

        # 激活值张量的梯度(闭包)函数
        def gradient_fn():
            x.grad += a.grad * (1 - a.data ** 2)

        a.gradient_fn = gradient_fn
        # 激活值张量的父节点列表
        a.parents = [x]
        return a
我们看一下 Tanh 激活函数的效果:
tanh = Tanh()

plt.figure(figsize=(5, 3))
x_range = np.arange(-10, 10, 0.1)
plt.plot(x_range, [tanh(Tensor(x)).data for x in x_range], linewidth=2)
plt.xlabel('x', fontsize=12)
plt.ylabel('y', fontsize=12)
plt.title('Tanh', fontsize=14, fontweight='bold')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()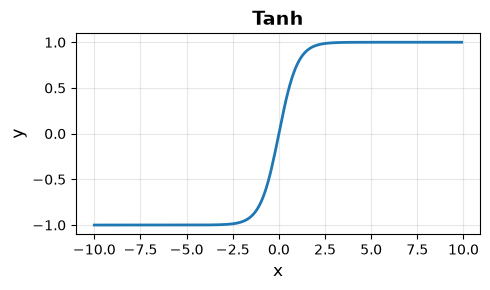
S 形曲线函数(Sigmoid)
S 形曲线函数(Sigmoid Function,也称 Logistic Curve)可以把任何数值平滑地压缩到 的范围之间。因此可以解释为某个事件发生的概率,常用于二元分类问题的输出层,来规范预测结果。
前向传播:逻辑回归的概率,将任意实数映射到 区间内。常用于二元分类问题的输出层。
梯度计算:Sigmoid 激活函数的导数也可以用其自身来表达。Sigmoid 激活函数的导数为:
Sigmoid 激活函数同样存在梯度饱和的问题。在深层网络中,可能梯度消失。此外,Sigmoid 激活函数还存在梯度衰减的问题。
父节点列表(parents):输入值。
参数列表(parameters):无。
class Sigmoid(Layer):

    def __init__(self, clip_range=(-100, 100)):
        super().__init__()
        self.clip_range = clip_range

    def forward(self, x: Tensor):
        # 裁剪数值,防止溢出
        z = np.clip(x.data, self.clip_range[0], self.clip_range[1])
        # 创建激活值张量
        a = Tensor(1 / (1 + np.exp(-z)))

        # 激活值张量的梯度(闭包)函数
        def gradient_fn():
            x.grad += a.grad * a.data * (1 - a.data)

        a.gradient_fn = gradient_fn
        # 激活值张量的父节点列表
        a.parents = [x]
        return a
我们看一下 Sigmoid 激活函数的效果:
sigmoid = Sigmoid()

plt.figure(figsize=(5, 3))
x_range = np.arange(-10, 10, 0.1)
plt.plot(x_range, [sigmoid(Tensor(x)).data for x in x_range], linewidth=2)
plt.xlabel('x', fontsize=12)
plt.ylabel('y', fontsize=12)
plt.title('Sigmoid', fontsize=14, fontweight='bold')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()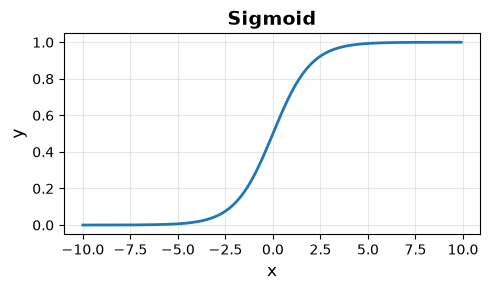
归一化指数函数(Softmax)
归一化指数函数(Normalized Exponential Function,Softmax)用于一组数值的情况,将它们转换为相互之间的相对比例,并维持总和为 1。因此常用于多元分类问题的输出层,数值最大的那个选项就是预测结果。
前向传播:将任意实数向量映射为一个概率分布,使得每个分量位于 区间内,且所有分量之和为 1。常用于多元分类问题的输出层。
梯度计算:Softmax 激活函数是一个向量函数,其梯度为雅可比矩阵(Jacobian Matrix)。Softmax 激活函数的导数为:
这里:
:Softmax 的第 个输出;
:损失函数对第 个输出的梯度,也就是从后面一层反向传回来的梯度;
:向量的分量个数。
这个公式的含义很直观:先算出所有输出按概率加权的平均梯度,然后输出每个分量和平均梯度的差值。
父节点列表(parents):输入值。
参数列表(parameters):无。
class Softmax(Layer):

    def __init__(self, axis=-1):
        super().__init__()
        self.axis = axis

    def forward(self, x: Tensor):
        # 创建激活值张量
        exp = np.exp(x.data - np.max(x.data, axis=self.axis, keepdims=True))
        a = Tensor(exp / np.sum(exp, axis=self.axis, keepdims=True))

        # 激活值张量的梯度(闭包)函数
        def gradient_fn():
            grad = np.sum(a.data * a.grad, axis=self.axis, keepdims=True)
            x.grad += a.data * (a.grad - grad)

        a.gradient_fn = gradient_fn
        # 激活值张量的父节点列表
        a.parents = [x]
        return a
我们看一下 Softmax 激活函数的效果:
softmax = Softmax()

x_range = np.arange(-10, 10, 0.1)
plt.figure(figsize=(5, 3))
plt.plot(x_range, [softmax(Tensor([x, 0.1, 0.9])).data for x in x_range], linewidth=2)
plt.xlabel('x', fontsize=12)
plt.ylabel('y', fontsize=12)
plt.title('Softmax', fontsize=14, fontweight='bold')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.legend(['x', '0.1', '0.9'])
plt.show()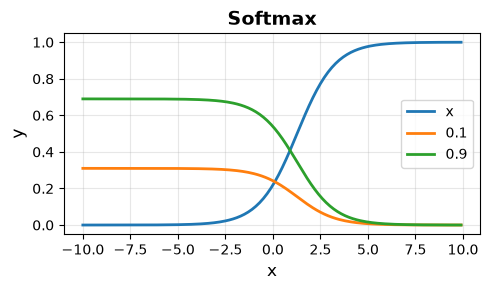
Softmax 激活函数是一个向量函数。所以我们可以看到各分量之间相互关系的变化。
图中我们比较了变量 和两个常量 0.1 和 0.9 经过 Softmax 激活函数后的输出。可以看到当 小于 0.9 的时候,最佳选择都是 0.9;而当 大于 0.9 以后,最佳选择变成了 ;而 0.1 永远都不是最佳选择。
损失函数(均方误差)
class MSELoss:

    def __call__(self, p: Tensor, y: Tensor):
        return self.loss(p, y)

    def loss(self, p: Tensor, y: Tensor):
        mse = Tensor(np.mean(np.square(y.data - p.data)))

        def gradient_fn():
            p.grad += -2 * (y.data - p.data) / y.data.size

        mse.gradient_fn = gradient_fn
        mse.parents = [p]
return mse优化器(随机梯度下降)
class SGDOptimizer:

    def __init__(self, parameters, lr):
        self.parameters = parameters
        self.lr = lr

    def zero_grad(self):
        for p in self.parameters:
            p.grad = np.zeros_like(p.data)

    def step(self):
        for p in self.parameters:
p.data -= p.grad * self.lr训练器
class Trainer:

    def __init__(self, model, loss_fn, optimizer):
        self.model = model
        self.loss_fn = loss_fn
        self.optimizer = optimizer

    def train(self, dataset, epochs):
        dataset.train()

        for epoch in range(epochs):
            for i in range(len(dataset)):
                feature, label = dataset[i]

                self.optimizer.zero_grad()
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                loss.backward()
                self.optimizer.step()

    def test(self, dataset):
        dataset.eval()

        feature, label = dataset.all()
        prediction = self.model(feature)
        loss = self.loss_fn(prediction, label)
return prediction, lossLEARNING_RATE = 0.00001批大小
BATCH_SIZE = 2轮数
EPOCHS = 1000建模
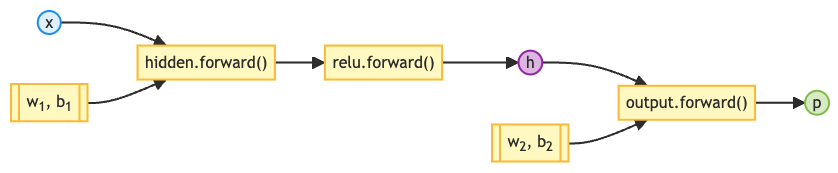
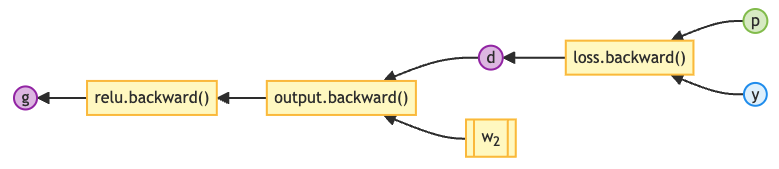
现在,让我们把 ReLU 激活函数用到隐藏层之后,看看会有什么样的效果。
💡 提示:通常在数值回归类型的模型中,输出层后面不需要激活函数。后续我们会看到,在分类模型中,输出层后面也会使用激活函数来辅助决策。
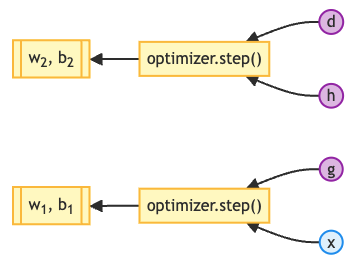
增加了隐藏层激活函数后,模型的三个核心流程也有了一些变化(参数更新没有变化):
前向传播:
反向传播:
参数更新:
dataset = Dataset(BATCH_SIZE)
model = Sequential([
    # 隐藏层
    Linear(2, 4),
    # 隐藏层激活函数
    ReLU(),
    # 输出层
    Linear(4, 1)
])
loss_fn = MSELoss()
optimizer = SGDOptimizer(model.parameters, lr=LEARNING_RATE)
trainer = Trainer(model, loss_fn, optimizer)训练
trainer.train(dataset, EPOCHS)评估
prediction, loss = trainer.test(dataset)
print(f'prediction:\t{prediction}\nloss:\t{loss}')
prediction: Tensor([[164.60610313]])
loss: Tensor(0.15515474192848927)
在上一个章节里,我们观察到两层网络模型虽然可行,但是并没有表现得比单层网络模型更出色,甚至有所减弱。
但是在我们使用了隐藏层激活函数后,损失值降到了 0.16,接近于 0。
这表明引入非线性激活函数后,模型具备了更强的表达能力,能够很好地拟合训练数据,并在测试样本上给出合理预测。
总结
四种激活函数的对比如下:
| 激活函数 | 主要用途 | 优点 | 缺点 | 推荐位置 |
|---|---|---|---|---|
| ReLU | 默认首选 处理非线性特征 | 计算快 在正区间无梯度饱和 缓解梯度消失 | 负区间梯度为 0 可能导致神经元“永久死亡” | 隐藏层 |
| Tanh | 有正负值的数据 | 输出零中心化(均值为 0) 使下一层收敛更快 | 存在梯度饱和 计算涉及指数,开销大 | 隐藏层 |
| Sigmoid | 二元分类概率预测 | 将输出平滑压缩至 区间 输出可解释为概率 | 输出均值不为 0 严重的梯度饱和 会导致梯度消失 | 二元分类 输出层 |
| Softmax | 多元分类概率预测 | 处理多个类别的概率 确保概率总和为 1 | 计算复杂 受极端数值影响大 | 多元分类 输出层 |
课后练习
尝试改用 Tanh 激活函数,或者在输出层后使用 Sigmoid 或者 Softmax 激活函数,看看训练效果如何?