罗马不是一日建成的。同样,网络模型也不是一次训练就可以学会的。
在深度学习中,模型训练遵循一个朴素的规则:利用海量数据,通过成千上万次的反复试错,以小步快跑的方式逐渐逼近最佳模型参数。这种重复且不断改进的过程,称为迭代(Iteration)。
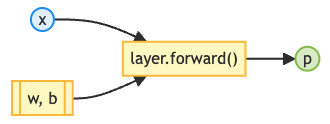
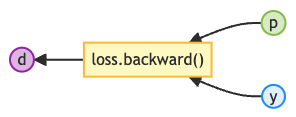
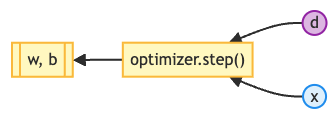
具体地讲,我们把一条数据提供给网络进行训练,并最终更新一次模型参数的过程,称为一次迭代。每次迭代包括三个步骤,比如对于我们的最简单的网络模型:
前向传播:
反向传播:
参数更新:
import numpy as np张量
class Tensor:

    def __init__(self, data):
        self.data = np.array(data)
        self.grad = np.zeros_like(self.data)
        self.gradient_fn = None
        self.parents = []

    def backward(self):
        if self.gradient_fn is not None:
            self.gradient_fn()

        for p in self.parents:
            p.backward()

    def __str__(self):
return f'Tensor({self.data})'数据集
模型训练所需要的海量数据,称为数据集(Dataset)。
数据集的每一条数据,称为一个样本(Sample)。每个样本包括特征和标签两部分。
通常数据集会被分成两部分:
训练集(Training Set):较多的一部分(比如:80%),用于模型训练;
测试集(Test Set):另一部分较少的(比如:20%),用于模型评估。
划分数据集的目的是为了保留一部分新数据:测试集。这样,可以用新数据验证训练过的网络模型是否真正学会了规律,而不是只死记硬背了一些内容。这就像是期末考试,老师不会用你做过的练习题做考卷,而是用一套新题来考察你是不是真的掌握了学习的知识。
小明提供了过去四天的天气预报和他的销售记录,作为我们的训练集;我们之前使用的数据则作为测试集。
数据集通常会提供的函数包括:
load(加载函数):加载全部数据;train(训练函数):切换到模型训练模式;eval(测试函数):切换到模型测试模式;all(全部样本):返回全部样本;__len__(样本数量):返回样本数量;__getitem__(index)(单个样本):根据索引(index)返回对应的样本。
class Dataset:

    def __init__(self):
        # 加载数据
        self.load()
        # 缺省使用训练集
        self.train()

    # 加载函数
    def load(self):
        # 训练集
        self.train_data = ([[22.5, 72.0],
                            [31.4, 45.0],
                            [19.8, 85.0],
                            [27.6, 63.0]],
                           [[95],
                            [210],
                            [70],
                            [155]])
        # 测试集
        self.test_data = ([[28.1, 58.0]],
                          [[165]])

    # 训练函数
    def train(self):
        self.data = self.train_data

    # 测试函数
    def eval(self):
        self.data = self.test_data

    # 全部样本
    def all(self):
        x, y = self.data
        return Tensor(x), Tensor(y)

    # 样本数量
    def __len__(self):
        x, *_ = self.data
        return len(x)

    # 单个样本
    def __getitem__(self, index):
        x, y = self.data
return Tensor(x[index]), Tensor(y[index])模型
class Linear:

    def __init__(self, in_size, out_size):
        self.weight = Tensor(np.ones((out_size, in_size)) / in_size)
        self.bias = Tensor(np.zeros(out_size))

    def __call__(self, x: Tensor):
        return self.forward(x)

    def forward(self, x: Tensor):
        p = Tensor(x.data @ self.weight.data.T + self.bias.data)

        def gradient_fn():
            self.weight.grad += p.grad * x.data
            self.bias.grad += np.sum(p.grad)

        p.gradient_fn = gradient_fn
        return p

    @property
    def parameters(self):
return [self.weight, self.bias]损失函数(均方误差)
class MSELoss:

    def __call__(self, p: Tensor, y: Tensor):
        return self.loss(p, y)

    def loss(self, p: Tensor, y: Tensor):
        mse = Tensor(np.mean(np.square(y.data - p.data)))

        def gradient_fn():
            p.grad += -2 * (y.data - p.data)

        mse.gradient_fn = gradient_fn
        mse.parents = [p]
return mse优化器(随机梯度下降)
为了适应模型训练时,需要进行多次迭代的新需求,我们对优化器进行升级,增加了一个新的函数:
zero_grad(清零函数):每次迭代开始前,清零所有梯度,准备开始下一轮梯度计算。
💡 提示:为什么每次迭代前需要清零?查看一下权重等张量的梯度函数,每次计算的梯度都是叠加的。如果每次迭代前不清零,新的梯度就会被叠加到上一次迭代累积的旧梯度上,越滚越大。
class SGDOptimizer:

    def __init__(self, parameters, lr):
        self.parameters = parameters
        self.lr = lr

    # 清零函数
    def zero_grad(self):
        for p in self.parameters:
            p.grad = np.zeros_like(p.data)

    def step(self):
        for p in self.parameters:
p.data -= p.grad * self.lrLEARNING_RATE = 0.00001建模
我们需要创建一个数据集的实例。
dataset = Dataset()
model = Linear(2, 1)
loss_fn = MSELoss()
optimizer = SGDOptimizer(model.parameters, lr=LEARNING_RATE)训练
现在我们的数据集拥有多个训练样本,所以我们需要一个逻辑循环:每次从数据集中取出一个样本,完成一次迭代。
每次迭代都遵循同样的五个步骤,这个顺序会在以后的章节保持稳定:
清零梯度(
zero_grad):清空上一次迭代计算的梯度;前向传播(
forward):计算预测值;计算损失(
loss):得到损失值;反向传播(
backward):计算计算图中所有节点的梯度;更新参数(
step):用梯度调整参数。
记住这个“五步循环”,它几乎是所有深度学习训练代码的核心骨架。
# 迭代
for i in range(len(dataset)):
    feature, label = dataset[i]

    # 清零梯度
    optimizer.zero_grad()
    # 前向传播(构建计算图)
    prediction = model(feature)
    # 计算损失
    loss = loss_fn(prediction, label)
    # 反向传播(计算梯度)
    loss.backward()
    # 更新参数
optimizer.step()推理
模型训练完成以后,我们要将数据集转换成测试模式,用新数据(测试集)来评估模型训练的效果。
# 使用测试集
dataset.eval()
feature, label = dataset.all()

prediction = model(feature)
print(f'prediction:\t{prediction}')
prediction: Tensor([[67.20489976]])
评估
loss = loss_fn(prediction, label)
print(f'loss:\t{loss}')
loss: Tensor(9563.881631333801)
从评估结果来看,经过 4 次迭代,损失值继续下降,网络模型的效果又有提高。但是仍然有很大的提升空间。
课后练习
训练数据迭代的次序会影响模型训练的效果吗?请尝试打乱训练数据的顺序(比如:改成逆序),再重新进行一次训练,观察结果有何不同。