上一章,我们利用微积分的链式法则,通过推理函数和损失函数的偏导数得到了模型参数的梯度。在现实应用中,网络模型可能有几十、上百层,包含百万、千万个人工神经元。面对如此庞大的深层网络模型,如果为每个参数都单独展开链式法则,计算量会呈指数级爆炸。因此我们需要构建一种机制,可以避免重复计算,自动完成不同基本运算的求导,并根据各个参数在网络中的位置实现动态的逐级链式合并。
在深度学习中采用的方法叫做计算图(Computational Graph)。
计算图
神经网络的计算并不是一步到位的。输入数据经过一层一层的神经元,每一步只做一个简单的局部运算,最终汇合到损失函数,得到损失值。这条数据流动的路径,就是前向传播。
为了能够计算梯度,我们需要在前向传播过程中,把数据流动的整个拓扑结构(Topology)全部记录下来:哪个节点的输出,成为了下一层哪个节点的输入。这个记录下来的拓扑结构,就称为计算图。
计算图中的每个节点(Node)可能是一个特征、模型参数、中间计算结果,或者最终的预测值、损失值。节点之间的边(Edge)代表数据的流向和依赖关系。有了计算图,我们就能沿着它反向追溯,逐级计算每个参数的梯度。
这种在前向传播过程中动态构建的计算图,被称为动态计算图(Dynamic Computational Graph)。与之对应的是静态计算图(Static Computational Graph),是先把整个图的结构定义好,再送入数据运行。PyTorch 采用动态计算图,TensorFlow 早期采用静态计算图(新版本也支持动态模式)。我们将采用动态计算图。
现在回头来看我们现有的,只有一个人工神经元的网络模型,它的完整计算图是这样的:
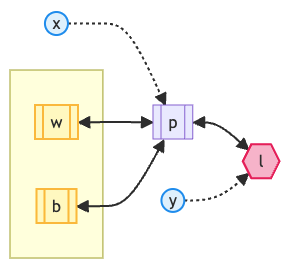
这里:
、:特征、标签,不需要训练的叶节点;
、:权重、偏置,需要训练的叶节点;
:预测值,中间节点;
:损失值,根节点。
import numpy as np张量
为了实现计算图,我们首先需要把每个节点从一个简单的数值(或者数组)扩展成一个可以容纳更多信息的数据结构,称为张量(Tensor)。
在数学上,张量是标量、向量和矩阵的统称与推广:单独一个数是标量(Scalar,0 维张量),一组数排成一行是向量(Vector,1 维张量),数排成行和列是矩阵(Matrix,2 维张量),更高维度的数组统称为张量。
在深度学习的框架里,张量是对多维数组的进一步封装。张量内部还包括构建计算图必要的数据结构,从而成为计算图的主要载体。
属性
每个张量将包括 4 个属性:
data(数据):这就是每个节点现有的数据,比如标签、参数值、预测值和损失值等。我们继续采用 NumPy 的数组来保存节点的现有数据;grad(梯度):这是根据链式法则,反向推导到这个节点的梯度值。梯度grad的数据结构需要和数据data保持一致;gradient_fn(梯度函数):这是一个闭包(Closure)函数,封装了当前节点的链式法则计算逻辑,用于计算出所有直接上游节点的梯度grad;parents(父节点列表):这是本节点的所有直接上游节点。梯度计算将沿着这个列表继续反向传播。
⚠️ 注意:不需要参与反向传播的直接上游节点(叶节点,比如特征)不必添加到父节点列表里。
反向函数
反向函数(backward)是张量内部最重要的一个函数,是链式法则的执行机制。每个张量的反向函数首先调用本身的梯度函数来计算直接上游节点的梯度,然后递归调用所有父节点的反向函数来完成反向传播。
这样,我们执行计算图最末端节点(根节点,通常是损失值)的反向函数,就可以递归调用整个计算图的所有节点的反向函数,完成所有节点的梯度计算。
class Tensor:

    def __init__(self, data):
        # 数据
        self.data = np.array(data)
        # 梯度
        self.grad = np.zeros_like(self.data)
        # 梯度(闭包)函数
        self.gradient_fn = None
        # 父节点列表(计算图)
        self.parents = set()

    # 反向函数(反向传播)
    def backward(self):
        # 计算梯度
        if self.gradient_fn is not None:
            self.gradient_fn()

        # 反向传播
        for p in self.parents:
            p.backward()

    def __str__(self):
return f'Tensor({self.data})'数据
特征、标签
所有的输入数据(特征、标签)都需要封装成张量。
所有的输入数据在计算图中都是叶节点(Leaf Node)。它们位于计算图的最底层,没有父节点,所以也不需要梯度函数。同时,我们也不需要计算输入数据的梯度(不需要训练输入数据)。
feature = Tensor([28.1, 58.0])
label = Tensor([165])模型
权重、偏置
所有的模型参数(权重、偏置)也都需要封装成张量。
目前所有的模型参数在计算图中同样都是叶节点。它们也没有父节点,也不需要梯度函数。和输入数据不同的是,我们需要计算模型参数的梯度,进而可以更新模型参数的数值。
推理函数
推理函数的输出数据(预测值)也要封装成张量。
所有的中间数据和输出数据都不是叶节点,它们有父节点,自然就也需要梯度函数(来计算父节点的梯度)。我们在预测值张量 的梯度函数 gradient_fn 中计算父节点(权重和偏置)的梯度,而另一个父节点(特征)则不需要计算梯度值。
我们没有设置 的父节点列表 parents,因为它的所有父节点(特征、权重和偏置)都是叶节点,本身没有梯度函数,无需参与反向传播。
模型作为前向传播的主要载体,在前向传播的同时,也动态构建起了计算图。
反向函数
梯度计算的功能已经转移到了预测值张量 的梯度函数 gradient_fn 中。模型的反向函数只剩下权重张量 和偏置张量 的参数更新的功能。
class Linear:

    def __init__(self, in_size, out_size):
        self.weight = Tensor(np.ones((out_size, in_size)) / in_size)
        self.bias = Tensor(np.zeros(out_size))

    def __call__(self, x: Tensor):
        return self.forward(x)

    # 推理函数(前向传播、构建计算图)
    def forward(self, x: Tensor):
        # 创建输出值张量
        p = Tensor(x.data @ self.weight.data.T + self.bias.data)

        # 输出值张量的梯度(闭包)函数
        def gradient_fn():
            self.weight.grad += p.grad * x.data
            self.bias.grad += np.sum(p.grad)

        p.gradient_fn = gradient_fn
        return p

    # 反向函数(更新参数)
    def backward(self):
        self.weight.data -= self.weight.grad
self.bias.data -= self.bias.grad损失函数(均方误差)
损失函数中,我们同样需要将损失值封装成张量。
损失值张量 mse 的父节点包括预测值 和标签 ,它的梯度函数 gradient_fn 计算了预测值 的梯度,也就是误差项。标签不需要计算梯度。
mse 的父节点列表 parents 只包括 ,因为 是叶节点,不必参与反向传播。
损失函数是前向传播的终点,也是计算图构建的终点;同时,它也是反向传播的起点。通过调用损失值张量的反向函数 backward,整张计算图将被反向递归调用,完成所有参数的梯度计算。
class MSELoss:

    def __call__(self, p: Tensor, y: Tensor):
        return self.loss(p, y)

    # 损失函数(前向传播的终点、构建计算图的根节点)
    def loss(self, p: Tensor, y: Tensor):
        # 创建损失值张量
        mse = Tensor(np.mean(np.square(y.data - p.data)))

        # 损失值张量的梯度(闭包)函数
        def gradient_fn():
            p.grad += -2 * (y.data - p.data)

        mse.gradient_fn = gradient_fn
        # 损失值张量的父节点列表
        mse.parents = [p]
return mse建模
model = Linear(2, 1)
loss_fn = MSELoss()训练
模型训练的过程需要增加一个步骤:调用损失值张量的反向函数,启动反向传播,沿着计算图完成所有参数的梯度计算。
# 前向传播(构建计算图)
prediction = model(feature)
# 计算损失
loss = loss_fn(prediction, label)
# 反向传播(计算梯度)
loss.backward()
# 更新参数
model.backward()推理
prediction = model(feature)
print(f'prediction:\t{prediction}')
prediction: Tensor([1013352.429])
评估
loss = loss_fn(prediction, label)
print(f'loss:\t{loss}')
loss: Tensor(1026548766283.6302)
本章我们引入了张量的概念,实现了自动微分(计算图构建和反向传播)的架构。
从模型推理和评估的结果来看,通过自动微分完成的模型训练达到了同样的效果,依旧是梯度发散。下一章,我们将引入学习率的概念来解决训练过程中梯度发散的问题。
课后练习
调试代码,尝试跟踪数据在模型、损失函数和张量中的流动,理解自动微分和动态计算图的实现原理。