合抱之木,生于毫末;九层之台,起于累土;千里之行,始于足下。
《道德经:第六十四章》
伟大的成就往往始于一个简单的想法。
深度学习(Deep Learning)也不例外。它起源于 1943 年一个极其朴素的数学模型:人工神经元(Artificial Neuron)。
人工神经元
人类的大脑并非一个整体的超级处理器,而是由大约 860 亿个神经元组成的复杂网络。单个神经元的能力非常有限:
接收信号;
判断信号强度;
决定是否通知下一个神经元。
把这种机制抽象出来,就是:输入、加权、过滤和输出。
受此启发,神经科学家麦卡洛克(McCulloch)与逻辑学家皮茨(Pitts)提出了著名的 M-P 神经元模型(McCulloch-Pitts Neuron):
这里:
:第 个输入值;
:对应的权重;
:阈值;
:输入的数量。
该模型包含两个核心思想:
线性回归(Linear Regression):对输入进行加权求和;
阶跃函数(Step Function):通过阈值 对信号进行过滤,决定是否向下传递。
💡 提示:最初的 M-P 模型使用阶跃函数。现代深度学习则改用“连续可导”的激活函数(Activation Function),这是能够使用梯度下降法进行模型训练的关键。
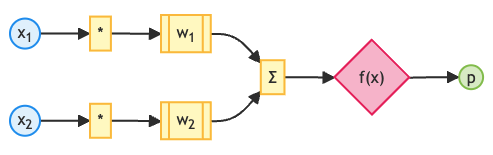
这里:
、:输入值;
、:权重;
:输出值;
:激活函数。
神经网络
单个神经元能力有限。但当我们将成千上万,甚至数以亿计的神经元连接并堆叠成多层结构时,就形成了功能强大的深度神经网络(Deep Neural Network,DNN)。多层结构给了神经网络更大的灵活性。每一层神经元都可以在前一层的基础上,组合出更加抽象、更加复杂的特征,并最终提炼出数据背后的深层规律。
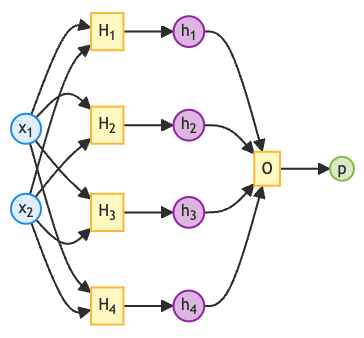
这里:
、:输入值;
、、、:第一层神经元;
、、、:中间值;
:第二层神经元;
:输出值。
现在,我们就从最简单的单神经元模型开始,逐步构建出能理解语言、生成内容的人工智能系统。
最简单的神经网络模型
一个仅含单个神经元的网络模型,虽然结构简单,却已经能完成许多实用任务,例如:
趋势预测:如房价、股票或销量预测;
影响分析:如健康风险评估、营销回报归因。
单个神经元的功能非常简单,就是完成一次加权求和(Weighted Sum),也就是线性回归:
这里:
:第 个输入数据,也称为特征(Feature);
:对应的权重(Weight);
:偏置(Bias);
:加权求和的计算结果,也称为预测值(Prediction)。
💡 提示:完整的神经元模型包括线性回归和激活函数两部分。在实践中,激活函数会被单独实现,与线性回归配合使用。我们首先专注于线性回归部分。
我们以一个冰激凌销量预测问题为例:
小明经营一家冰激凌店,发现销量与天气密切相关。他希望构建一个网络模型,根据每天的温度和湿度预测当天的冰激凌销量。
import numpy as np💡 提示:NumPy 是 Python 的核心科学计算库,提供高效的多维数组(
ndarray)和向量化运算。本书将全程使用 NumPy 实现所有计算。
数据
特征
小明找来了今天的天气预报,于是我们有了第一组输入数据(也称为特征),包含温度 28.1°C 和湿度 58% 两项数值。
我们用一个 NumPy 数组保存今天的天气情况:[温度, 湿度]。
feature = np.array([28.1, 58.0])模型
模型(Model)包含完成预测所需的全部参数(Parameter,即权重和偏置)和计算逻辑(即推理函数)。
参数:权重、偏置
权重的数量和特征的数量一一对应。比如:特征 包含两个数值(温度和湿度),权重也必须是两个数值:。
权重代表每个特征对预测结果的影响力。例如,如果 很大而 很小,就说明大家主要因为 (天气太热)购买冰激凌,而非因为 (空气潮湿)。
偏置只有一个数值,代表不受任何特征影响的基础销量。比如来自铁杆冰激凌爱好者的稳定购买,无论天气如何他们都会买。
我们同样用 NumPy 数组来保存参数:
权重:二维数组,格式为
(神经元数量, 特征数量)。每一行对应一个神经元的所有权重。而神经元的数量对应预测值的数量,每个神经元产生一个预测值。偏置:一维数组,格式为
(神经元数量,)。每个数值对应一个神经元的偏置。
推理函数
推理函数实现加权求和(线性回归)的功能。这种数据从输入向输出方向的流动,称为前向传播(Forward Propagation),因此推理函数也常常称为前向函数(Forward Function)。
利用 NumPy 的矩阵运算可以高效地实现线性回归:
在代码中,x @ self.weight.T 就等价于上面的矩阵乘法。其中 @ 是矩阵乘法运算符,self.weight.T 是对权重矩阵做转置(Transpose),将其行和列对调,格式从 (1, 2) 变为 (2, 1),使矩阵乘法的维度能够正确匹配。计算结果是一个只包含一个数值的数组,格式为 (1,),也就是我们希望得到的预测值。
class Linear:

    def __init__(self, in_size, out_size):
        # 权重
        self.weight = np.ones((out_size, in_size)) / in_size
        # 偏置
        self.bias = np.zeros(out_size)

    def __call__(self, x):
        return self.forward(x)

    # 推理函数(前向传播)
    def forward(self, x):
        return x @ self.weight.T + self.bias
💡 提示:作为初始值,我们假设温度和湿度对销量的影响力相同,各给 0.5 的权重,偏置设为 0(因为暂时不知道稳定基础销量是多少)。这两个假设并不准确,模型训练的目标,正是从数据中自动找到更好的参数。
以上短短几行代码,我们已经构建出一个最简单的可以运行的神经网络!
建模
运行模型前,我们首先需要创建一个模型的实例:输入是 2 个特征,输出是 1 个预测值。
model = Linear(2, 1)prediction = model(feature)
print(f'prediction:\t{prediction}')prediction: [43.05]