在前十章,我们从零搭建了一套基本的神经网络训练框架,并用它实现了一个两层的网络模型来预测冰激凌的销量。同样的方法,可以用来解决大量的回归(Regression)与分类(Classification)问题。
⚠️ 注意:在分类问题中,将会使用到输出层激活函数的辅助。
现实生活中,还有另外一类大量存在,也更加复杂的问题:时间序列(Time Series)。
这一类数据的特点,是有明确的先后顺序。我们不能只看当前的一组数据,还要参考之前的所有数据。比如股价,我们不能只看今天的价格,还要参考之前很长时间的股价变化来做分析。
在所有时间序列数据中,最贴近人类智能,也最复杂的,莫过于语言。从这一部分开始,我们将扩充我们的神经网络训练框架,尝试处理文字信息。
我们面对的第一个问题是:如何数字化文字信息。神经网络只能处理数字信息,我们需要一种方法将文字转换成数字。
索引编码
一种最直接的方法是:把所有字符(或者单词)排列起来,依次给它们一个编号,称为索引编码(Index Encoding)。
比如:以 26 个英文字母为例,排在前三位的字母分别是 A、B、C,那么它们的索引编码就分别是 0、1、2,而 X、Y、Z 的索引编码就分别是 23、24、25。
但是索引编码仍然不适用于神经网络,因为可能会让模型认为 1 代表的 B 大于 0 代表的 A。
独热编码
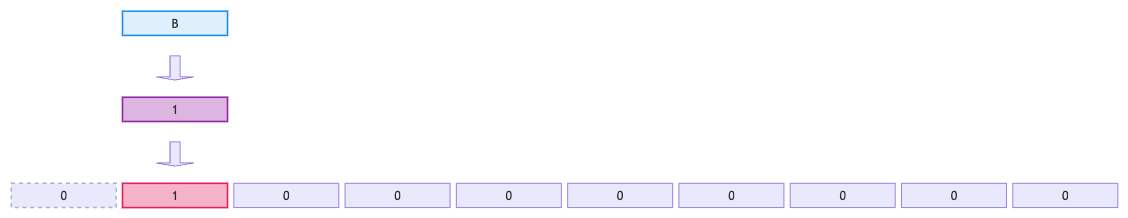
更好的解决办法是独热编码(One-Hot Encoding)。它的核心思想非常直观:比如还以 26 个英文字母为例,把每一个字母映射为一个向量,向量的长度和字母的总数(26)相同。在这个向量中,永远只有一个位置的值是 1(对应索引编码的位置),而其余所有位置的值都是 0。
比如:A 的独热编码是:[1, 0, 0 ... 0],B 的独热编码是:[0, 1, 0 ... 0],Z 的独热编码是:[0, 0, 0 ... 1]。这样,所有字母的编码在数学上等距,谁也不比谁特殊。
那我们怎么表示一个词,甚至一句话呢?
词袋
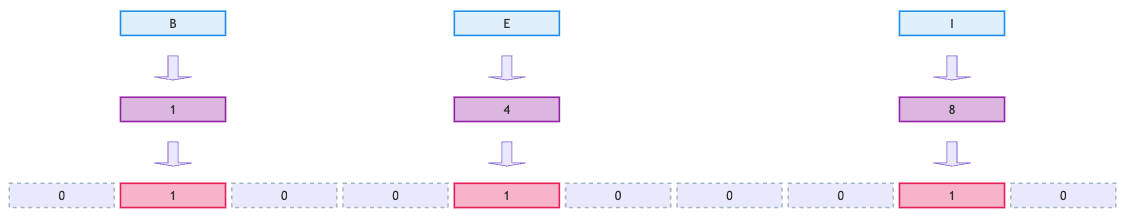
一种简单,但是有效的办法是词袋(Bag of Words):把整个词,甚至整个句子里所有字母的独热编码向量加起来,得到一个向量和,就可以有效地表示这个词或者句子里出现过哪些字符、以及各出现了几次。
比如:BED 的词袋是:[0, 1, 0, 1, 1, 0 ... 0],BEE 的词袋是:[0, 1, 0, 0, 2, 0 ... 0]。
💡 提示:词袋模型简单明了,但是也有一个明显的缺点:它丢失了字符的顺序。比如
EAT和TEA的词袋表示就完全一样,无法分辨。
from abc import ABC, abstractmethod
from pathlib import Path

import numpy as np
import requestsnp.random.seed(42)张量
class Tensor:

    def __init__(self, data):
        self.data = np.array(data)
        self.grad = np.zeros_like(self.data)
        self.gradient_fn = None
        self.parents = set()

    def backward(self):
        if self.gradient_fn is not None:
            self.gradient_fn()

        for p in self.parents:
            p.backward()

    def __str__(self):
return f'Tensor({self.data})'数据集
我们将前十章里数据集的具体数据去掉,改造成一个具备基本功能的数据集抽象类。
抽象类
抽象类保留了所有数据集必须提供的基本功能:
load(加载函数):加载数据,这是一个抽象函数接口;train(训练函数):提供训练集数据;eval(测试函数):提供测试集数据;all(全部样本):读取全部样本;__len__(样本数量):返回样本数量;__getitem__(单个样本):根据索引读取样本。
class Dataset(ABC):

    def __init__(self, batch_size=1):
        self.batch_size = batch_size
        self.load()
        self.train()

    @abstractmethod
    def load(self):
        pass

    def train(self):
        self.data = self.train_data

    def eval(self):
        self.data = self.test_data

    def all(self):
        x, y = self.data
        return Tensor(x), Tensor(y)

    def __len__(self):
        x, *_ = self.data
        return len(x) // self.batch_size

    def __getitem__(self, index):
        s = slice(index * self.batch_size, (index + 1) * self.batch_size)
        x, y = self.data
return Tensor(x[s]), Tensor(y[s])字符编码数据集
从这一部分开始,我们将聚焦在纯文本数据。
分词
在处理纯文本数据时,我们遇到的第一个问题往往是如何划分数据单元,称为分词(Tokenization)。常见的方法有:
按词划分(Word Level):语义完整,符合语言习惯;但是词表(Vocabulary)通常非常庞大,比如英文词表可能达到数万,甚至上十万。而且无法很好地处理未登录的词,比如新词、生僻词。
按字符划分(Character Level):词表非常小,比如英文词表只有几十个字符,也没有新词和生僻词的问题。但是损失了词汇语义,而且分词后数据序列会非常长。
按子词划分(Subword Level):这是现代大语言模型中最主流的方法,介于词和字符之间,试图平衡词表大小和语义表达。它会将常见词保留完整,而将罕见词拆分为更小的子词单位(Subwords)。目前最常用的算法是字节对编码(Byte Pair Encoding,BPE):从字符开始,通过统计频次,逐步合并最常共同出现的字符对。
我们将采用按字符划分的方式。这是构建微型 LLM 的常见选择,适合处理微型数据集,算力要求低。
预处理
用作数据集的是大段的完整文本,比如我们将采用精选的莎士比亚剧本(tinyshakespeare)。
加载文本以后,我们首先需要进行预处理:
构建词表:统计文本用到的所有字母、数字、标点和其他特殊字符,组成词表;
索引编码:对词表中的所有字符进行索引编码。
经过预处理后,数据集将包括:
vocab(词表):所有用到的字符的汇总;索引表:
stoi(正向索引表):从字符到索引编码的对照表;itos(反向索引表):从索引编码到字符的对照表;
tokens(词元表):对全部文本转换成索引编码,这是模型可以处理的数据。
字符编码数据集还将提供两个额外的函数:
encode(编码函数):返回文本的索引编码;decode(解码函数):将索引编码转换回文本。
特征、标签
经过预处理的词元表最终会被分割出特征和标签。根据不同的任务场景,可以有多种分割方法:
文本分类任务:比如垃圾邮件分类、顾客反馈分析等。
特征:一封邮件,或者一段顾客留言的词元序列;
标签:类别(比如:将垃圾邮件标记为
1,或者顾客的打分1到5);
序列标注任务:比如词性标注、实体识别等。
特征:一段词元序列(比如:
[he, is, young]);标签:与词元词性对应的标签序列(比如:
[N, V, J])。
自监督训练:比如 GPT 模型预测下一个词。
特征:在训练文本中截取一段词元序列;
标签:特征词元序列之后的下一个词元。
文本分类和序列标注任务都需要额外的数据(比如顾客的打分),或者人工标注。而大语言模型通常采用自监督训练的模式,这也是我们将采用的方式。
示例
举例说明一下语言模型是怎样实现文本生成的。假设我们的训练文本是这样一段文字:
BUCKINGHAM: My lord, I claim your gift, ...模型训练时,我们每次从文本中截取若干(比如:8 个)字符作为特征。第一次训练就是:BUCKINGH;而我们要预测的就是第 9 个字符:A。
我们将特征的独热编码组成词袋,就是:
[0, 1, 1, 0, 0, 0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0 ...]而标签的独热编码就是:
[1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0 ...]所以语言模型的本质就是通过一个编码数组,来预测另一个编码数组的多元分类(Multi-class Classification)模型。
第二次训练我们将顺序向后平移一个或者多个字符,再次截取数据。比如我们选择隔两个字符,那么这次的特征就是:CKINGHAM;而标签就是::。
它们的编码(特征词袋、标签独热编码)就分别是:
[1, 0, 1, 0, 0, 0, 1, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0 ...]
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1 ...]
之后我们继续向后平移截取新的训练数据,直到整个训练文本的末尾,就完成了一个轮次。
初始化参数
字符编码数据集需要三个额外的初始化参数:
context_size(上下文尺寸):每次截取多少个词元作为特征;stride(上下文步幅):隔开多少个词元开始截取下一个标签,我们采用上下文尺寸的一半作为缺省值;split(训练集、测试集比例):就是我们会使用多少比例的文本作为训练集,剩下的文本则用作测试集。
class CharDataset(Dataset):

    def __init__(self, filename, batch_size=1, context_size=64, stride=None, split=0.9):
        self.filename = filename
        self.context_size = context_size
        self.stride = stride if stride is not None else context_size // 2
        self.split = split
        super().__init__(batch_size)

    def load(self):
        with open(self.filename, encoding="utf-8") as f:
            text = f.read()

        # 词表
        self.vocab = sorted(set(text))
        self.vocab_size = len(self.vocab)
        # 索引表
        self.stoi = {ch: i for i, ch in enumerate(self.vocab)}
        self.itos = {i: ch for i, ch in enumerate(self.vocab)}
        # 词元表
        self.tokens = self.encode(text)

        # 划分训练集、测试集
        split = int(len(self.tokens) * self.split)
        self.train_data = self._pack(self.tokens[:split])
        self.test_data = self._pack(self.tokens[split:])

    # 截取样本
    def _pack(self, tokens):
        onehot = np.eye(self.vocab_size)
        x, y = [], []
        for i in range(0, len(tokens) - self.context_size - 1, self.stride):
            # 特征:独热编码词袋
            x.append(onehot[tokens[i: i + self.context_size]].sum(axis=0))
            # 标签:独热编码
            y.append(onehot[tokens[i + self.context_size]])
        return x, y

    # 编码函数
    def encode(self, symbols):
        return [self.stoi[s] for s in symbols]

    # 解码函数
    def decode(self, tokens):
return "".join(self.itos[t] for t in tokens)class Layer(ABC):
def __call__(self, x: Tensor):
return self.forward(x)
@abstractmethod
def forward(self, x: Tensor):
pass
@property
def parameters(self):
return []线性层
class Linear(Layer):

    def __init__(self, in_size, out_size):
        self.weight = Tensor(np.random.randn(out_size, in_size) * np.sqrt(2 / in_size))
        self.bias = Tensor(np.zeros(out_size))

    def forward(self, x: Tensor):
        p = Tensor(x.data @ self.weight.data.T + self.bias.data)

        def gradient_fn():
            self.weight.grad += p.grad.T @ x.data
            self.bias.grad += np.sum(p.grad, axis=0)
            x.grad += p.grad @ self.weight.data

        p.gradient_fn = gradient_fn
        p.parents = [x]
        return p

    @property
    def parameters(self):
return [self.weight, self.bias]顺序层
class Sequential(Layer):

    def __init__(self, layers):
        self.layers = layers

    def forward(self, x: Tensor):
        for l in self.layers:
            x = l(x)
        return x

    @property
    def parameters(self):
return [p for l in self.layers for p in l.parameters]class ReLU(Layer):
def forward(self, x: Tensor):
a = Tensor(np.maximum(0, x.data))
def gradient_fn():
x.grad += a.grad * (a.data > 0)
a.gradient_fn = gradient_fn
a.parents = [x]
return a归一化指数函数(Softmax)
class Softmax(Layer):

    def __init__(self, axis=-1):
        super().__init__()
        self.axis = axis

    def forward(self, x: Tensor):
        exp = np.exp(x.data - np.max(x.data, axis=self.axis, keepdims=True))
        a = Tensor(exp / np.sum(exp, axis=self.axis, keepdims=True))

        def gradient_fn():
            grad = np.sum(a.data * a.grad, axis=self.axis, keepdims=True)
            x.grad += a.data * (a.grad - grad)

        a.gradient_fn = gradient_fn
        a.parents = [x]
return a损失函数(均方误差)
class MSELoss:

    def __call__(self, p: Tensor, y: Tensor):
        return self.loss(p, y)

    def loss(self, p: Tensor, y: Tensor):
        mse = Tensor(np.mean(np.square(y.data - p.data)))

        def gradient_fn():
            p.grad += -2 * (y.data - p.data) / y.data.size

        mse.gradient_fn = gradient_fn
        mse.parents = [p]
return mse优化器(随机梯度下降)
class SGDOptimizer:

    def __init__(self, parameters, lr):
        self.parameters = parameters
        self.lr = lr

    def zero_grad(self):
        for p in self.parameters:
            p.grad = np.zeros_like(p.data)

    def step(self):
        for p in self.parameters:
p.data -= p.grad * self.lr训练器
对于文本生成模型,我们在训练器里添加了一个新的生成函数 generate。即根据一段提示词(Prompt),由模型自动续写后续内容。
生成函数的逻辑和测试函数基本一致。区别是将提示词当作数据集,同时将新生成的字符逐一添加到提示词后,从而将数据集不断扩展,将推理过程不断延续下去。
比如我们使用 ROMEO: 作为提示词。模型生成下一个字符为:D;那么下一轮我们提示词扩展为:ROMEO:D,模型据此生成下一个字符为:e;我们的提示词再次扩展为:ROMEO:De,模型持续地按照扩展的提示词生成新的字符。
class Trainer:

    def __init__(self, model, loss_fn, optimizer):
        self.model = model
        self.loss_fn = loss_fn
        self.optimizer = optimizer

    def train(self, dataset, epochs):
        dataset.train()

        for epoch in range(epochs):
            for i in range(len(dataset)):
                feature, label = dataset[i]

                self.optimizer.zero_grad()
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                loss.backward()
                self.optimizer.step()

    def test(self, dataset):
        dataset.eval()

        feature, label = dataset.all()
        prediction = self.model(feature)
        loss = self.loss_fn(prediction, label)
        return prediction, loss

    # 生成函数
    def generate(self, dataset, prompt, steps=256):
        tokens = dataset.encode(prompt)
        onehot = np.eye(dataset.vocab_size)

        for _ in range(steps):
            # 推理
            window = tokens[-dataset.context_size:]
            feature = Tensor([onehot[window].sum(axis=0)])
            prediction = self.model(feature)

            # 采样
            probs = prediction.data[0] / np.sum(prediction.data[0])
            token = np.random.choice(len(probs), p=probs)
            # 新词元并入提示词
            tokens.append(token)

return dataset.decode(tokens)LEARNING_RATE = 0.01批大小
BATCH_SIZE = 4轮数
EPOCHS = 10上下文尺寸
这是一个新的超参数。上下文尺寸(Context Size)定义了每次从词元表中截取的数据长度,就是我们每次训练用多长的文本来预测下一个字母。
较长的上下文尺寸可以提供更多的信息来做推理,提高推理准确度。但是也会增加训练和推理的算力需求,因此需要综合考虑。最初的大语言模型通常采用 1024 到 4096 这个范围的上下文尺寸。目前的顶尖大语言模型已经可以做到超过 1M 的上下文尺寸。
CONTEXT_SIZE = 32数据准备
在开始训练之前,还有最后一步准备工作,就是下载训练数据。我们将采用教学中非常流行的数据集:微型莎士比亚剧本(tinyshakespeare),可以从下面的 URL 下载。
DATA_FILE = "../../../../data/tinyshakespeare.txt"

file = Path(DATA_FILE)
if not file.exists():
    file.parent.mkdir(parents=True, exist_ok=True)
    url = "https://raw.githubusercontent.com/karpathy/char-rnn/master/data/tinyshakespeare/input.txt"
    response = requests.get(url)
    response.raise_for_status()
file.write_text(response.text)建模
我们将建立一个两层的网络模型:
Linear(vocab_size, vocab_size * 2):第一层(隐藏层)的输入值是一组(上下文尺寸)词元的词袋,数据大小就是数据集词表(vocab)的大小。我们选择第一层输出值的大小是输入值的两倍;ReLU():第一层后我们使用 ReLU 作为隐藏层激活函数,这是标准的做法;Linear(vocab_size * 2, vocab_size):第二层(输出层)的输入值是第一层的输出值。而第二层输出值就是预测值,即下一个字母的独热编码。因此输出值大小也是数据集词表(vocab)的大小;Softmax():第二层后我们使用 Softmax 作为输出层激活函数。这是因为模型的输出实际上就是一个多元分类,即从数据集词表中选出概率最大的字符。
模型的输入数据(特征)格式是:(批大小, 词表大小);隐藏层的输出数据格式是:(批大小, 词表大小 * 2);输出层的输出数据(预测值)格式恢复到:(批大小, 词表大小)。
dataset = CharDataset(DATA_FILE, BATCH_SIZE, CONTEXT_SIZE)
model = Sequential([
    # 隐藏层
    Linear(dataset.vocab_size, dataset.vocab_size * 2),
    # 隐藏层激活函数
    ReLU(),
    # 输出层
    Linear(dataset.vocab_size * 2, dataset.vocab_size),
    # 输出层激活函数
    Softmax()
])
loss_fn = MSELoss()
optimizer = SGDOptimizer(model.parameters, lr=LEARNING_RATE)
trainer = Trainer(model, loss_fn, optimizer)训练
trainer.train(dataset, EPOCHS)评估
prediction, loss = trainer.test(dataset)
print(f'prediction:\t{prediction.data.shape}\nloss:\t{loss}')
prediction: (6970, 65)
loss: Tensor(0.014733022893551677)
推理
最后,我们将使用训练的模型来完成第一次文本生成,提示词是:ROMEO:。
print(trainer.generate(dataset, prompt="ROMEO:"))ROMEO:Et
KiQ $fxaXKB
BS3 itwg
k inlxjh?s,sG o
o,sooH r Tna t
y! i ot
se3Au ti isrhsBtsiqhifTeIaJ LoMl;Y.:ihGbr. k yheaf!tf:e'
ffe&d echsrwwjtsh oKj Jht spMW
e-CshoBorowpoo a
3wKxo.f xo
so
oo o
c
to O o
oto-UnoooUt oo oto
!V xoLupAU:xctLs xtTomtLZrlWo lANece
我们期待模型续写一段罗密欧的对话,不出预料地得到了一段几乎是乱码的输出。
这一章,我们成功地实现了一个可以学习文本信息,并实现文本输出的语言模型。后续的几个章节,我们将逐步扩展模型的性能,提高模型的输出能力。
课后练习
上下文尺寸可以说是语言模型最重要的超参数,试一试修改成不同的数值(比如:改小到
16或者改大到64),看看训练后输出的文本有什么不同?