上一章,我们通过位置嵌入让 GPT 模型知道了每个词元在哪里。接下来,就需要让模型在此基础上和周边的词元邻居互动起来。
RNN 模型通过隐状态将前面词元的信息传递给当前词元做参考。而 GPT 模型的并行处理模式同步处理所有词元,每个词元都不知道其他词元的状况。我们需要像用位置向量告诉模型词元位置一样,显式地告诉模型当前词元和所有其他词元的关联。
举例来说,人类是怎样阅读理解的?比如我们读这句话:
小明买了苹果,没有买香蕉,因为它很新鲜。
当我们读到“它”的时候,我们会回顾前面的内容,并把注意力更多地落在“苹果”上,而不是“香蕉”上。这种根据当前内容,回顾并权衡上下文的能力,就是我们要模拟的,称为注意力机制(Attention Mechanism)。
注意力机制
注意力机制的核心思想是:在处理每个词元时,先回头看一眼上下文中所有词元,并根据相关程度给它们分配不同的权重:
相关程度高的词元,权重大、贡献多;
相关程度低的词元,权重小、贡献少。
自注意力
自注意力(Self-Attention)是注意力机制的一种:词元关注的不是别的序列,而是词元自己所在的序列本身。每个词元都同时扮演两个角色:
关注者:别的词元对我有什么影响?
被关注者:我对别的词元有什么影响?
注意力权重
那么我们怎么衡量两个词元的相关程度?一个简单而有效的办法就是计算它们词向量的点积(Dot Product):
点积的几何意义是两个向量方向的一致性:方向越接近,点积越大,说明两个词元越相关。
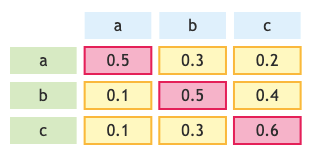
把所有词元两两计算点积,就得到一个注意力分数矩阵(Attention Scores),格式为 (上下文尺寸, 上下文尺寸)。其中第 行第 列的数值,表示第 个词元对第 个词元的相关程度。
注意力分数矩阵的数值范围不受控制,直接用于计算会很不稳定。我们用 Softmax 激活函数把每一行转换成概率分布,就得到注意力权重(Attention Weights):每一行的所有权重之和为 1。
import numpy as np

from src.core import *np.random.seed(42)class CharDataset(Dataset):
def __init__(self, filename, batch_size=1, context_size=64, stride=None, split=0.9):
self.filename = filename
self.context_size = context_size
self.stride = stride if stride is not None else context_size // 2
self.split = split
super().__init__(batch_size)
def load(self):
with open(self.filename, encoding="utf-8") as f:
text = f.read()
self.vocab = sorted(set(text))
self.vocab_size = len(self.vocab)
self.stoi = {ch: i for i, ch in enumerate(self.vocab)}
self.itos = {i: ch for i, ch in enumerate(self.vocab)}
self.tokens = self.encode(text)
split = int(len(self.tokens) * self.split)
self.train_data = self._pack(self.tokens[:split])
self.test_data = self._pack(self.tokens[split:])
def _pack(self, tokens):
x, y = [], []
for i in range(0, len(tokens) - self.context_size - 1, self.stride):
x.append(tokens[i: i + self.context_size])
y.append(tokens[i + 1: i + self.context_size + 1])
return x, y
def encode(self, symbols):
return [self.stoi[s] for s in symbols]
def decode(self, tokens):
return "".join(self.itos[t] for t in tokens)class GELU(Layer):
def __init__(self):
super().__init__()
self.c = np.sqrt(2.0 / np.pi)
def forward(self, x: Tensor):
tanh = np.tanh(self.c * (x.data + 0.044715 * x.data ** 3))
a = Tensor(0.5 * x.data * (1.0 + tanh))
def gradient_fn():
grad = 0.5 * (1.0 + tanh) + 0.5 * x.data * (1.0 - tanh ** 2) * self.c * (1.0 + 3.0 * 0.044715 * x.data ** 2)
x.grad += a.grad * grad
return a.attach(gradient_fn, parents=[x])class GPTLoss(Loss):
def loss(self, p: Tensor, y: Tensor):
exp = np.exp(p.data - np.max(p.data, axis=-1, keepdims=True))
softmax = exp / np.sum(exp, axis=-1, keepdims=True)
flat_softmax = softmax.reshape(-1, softmax.shape[-1])
flat_y = y.data.reshape(-1).astype(np.int64)
n = len(flat_y)
rows = np.arange(n)
log = np.log(np.clip(flat_softmax[rows, flat_y], 1e-10, 1))
ce = Tensor(0 - np.sum(log) / n)
def gradient_fn():
flat_grad = flat_softmax.copy()
flat_grad[rows, flat_y] -= 1
p.grad += ce.grad * flat_grad.reshape(softmax.shape) / n
return ce.attach(gradient_fn, parents=[p])class GPTEmbedding(Composite):
def __init__(self, vocab_size, context_size, embedding_size):
self.embedding = Embedding(vocab_size, embedding_size)
self.positional_embedding = Embedding(context_size, embedding_size)
super().__init__([self.embedding,
self.positional_embedding])
def forward(self, x: Tensor):
token = self.embedding(x)
position = self.positional_embedding(Tensor(range(x.shape[1])))
return token + positionGPT 注意力层
我们新增 GPT 注意力层(GPT Attention Layer)来为每个词元的嵌入向量(词向量 + 位置向量)添加来自其他词元的注意力:
计算注意力分数矩阵:;
缩放:乘以 ,防止数值过大。这里 是嵌入尺寸
embedding_size;计算注意力权重:用 Softmax 激活函数将每一行转换成概率分布;
加权求和:注意力权重乘以嵌入向量,得到融合上下文的新的注意力向量(Attention Vector)。
最终,我们得到缩放点积注意力(Scaled Dot-Product Attention):
这就是 Transformer 论文中的核心公式。
代码里在公式之外还多了一步:加权求和的结果会再经过一个线性层 self.output(输出投影),才作为注意力层的最终输出。
class GPTAttention(Composite):

    def __init__(self, embedding_size):
        self.embedding_size = embedding_size

        # 激活函数层
        self.softmax = Softmax()
        # 输出层
        self.output = Linear(embedding_size, embedding_size)

        super().__init__([self.softmax,
                          self.output])

    def forward(self, x: Tensor):
        # 缩放因子
        scale = Tensor(np.array(1.0 / np.sqrt(self.embedding_size)))
        # 注意力分数矩阵
        scores = x @ x.transpose((0, 2, 1)) * scale
        # 注意力权重
        weights = self.softmax(scores)
        # 缩放点积注意力
        return self.output(weights @ x)
GPT 前馈网络层
class GPTFeedForward(Composite):

    def __init__(self, embedding_size):
        self.input = Linear(embedding_size, embedding_size * 4)
        self.gelu = GELU()
        self.output = Linear(embedding_size * 4, embedding_size)

        super().__init__([self.input,
                          self.gelu,
                          self.output])

    def forward(self, x: Tensor):
        h = self.gelu(self.input(x))
        return self.output(h)
GPT Transformer 模块
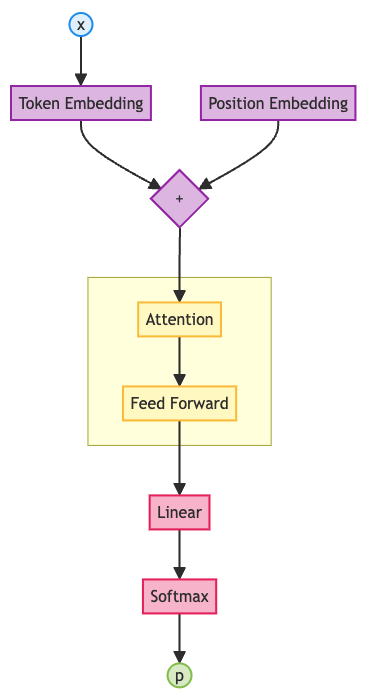
现在,我们拥有了完整的 Transformer 模块:注意力层 + 前馈网络层。
注意力层:让词元之间互相交流,融合上下文信息;
前馈网络层:对融合后的注意力向量进一步提炼特征。
class GPTTransformer(Composite):

    def __init__(self, embedding_size):
        # 注意力层
        self.attention = GPTAttention(embedding_size)
        # 前馈网络层
        self.feed_forward = GPTFeedForward(embedding_size)

        super().__init__([self.attention,
                          self.feed_forward])

    def forward(self, x: Tensor):
        x = self.attention(x)
        return self.feed_forward(x)
GPT 输出层
class GPTOutput(Composite):

    def __init__(self, embedding_size, vocab_size):
        self.output = Linear(embedding_size, vocab_size)

        super().__init__([self.output])

    def forward(self, x: Tensor):
        return self.output(x)
GPT 模型
class GPT(Composite):

    def __init__(self, vocab_size, context_size, embedding_size, blocks):
        self.embedding = GPTEmbedding(vocab_size, context_size, embedding_size)
        self.transformers = [GPTTransformer(embedding_size) for _ in range(blocks)]
        self.output = GPTOutput(embedding_size, vocab_size)

        super().__init__([self.embedding] + self.transformers + [self.output])

    def forward(self, x: Tensor):
        x = self.embedding(x)
        for layer in self.transformers:
            x = layer(x)
        return self.output(x)
GPT 训练器
class GPTTrainer(Trainer):

    def train(self, dataset, epochs, scheduler=None):
        dataset.train()
        self.model.train()

        steps = 0
        for epoch in range(epochs):
            for i in range(len(dataset)):
                if scheduler is not None:
                    self.optimizer.lr = scheduler.step(steps)

                feature, label = dataset[i]

                self.optimizer.zero_grad()
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                loss.backward()
                self.optimizer.clip_grad_norm()
                self.optimizer.step()
                steps += 1

    def test(self, dataset):
        dataset.eval()
        self.model.eval()

        predictions = []
        total_loss = 0.0
        with Tensor.no_grad():
            for i in range(len(dataset)):
                feature, label = dataset[i]
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                predictions.append(prediction)
                total_loss += float(loss.data)

        loss = total_loss / len(dataset)
        dataset.train()
        self.model.train()
        return predictions, loss

    def generate(self, dataset, prompt, steps=256):
        self.model.eval()
        tokens = dataset.encode(prompt)

        with Tensor.no_grad():
            for _ in range(steps):
                feature = Tensor([tokens[-dataset.context_size:]])
                logits = self.model(feature)

                last_logits = logits.data[0, -1]
                exp = np.exp(last_logits - np.max(last_logits))
                probs = exp / np.sum(exp)
                token = np.random.choice(len(probs), p=probs)
                tokens.append(token)

return dataset.decode(tokens)LEARNING_RATE = 0.001批大小
BATCH_SIZE = 4轮数
EPOCHS = 2上下文尺寸
CONTEXT_SIZE = 32嵌入尺寸
EMBEDDING_SIZE = 64Transformer 模块数
BLOCKS = 2建模
DATA_FILE = "../../../../data/tinyshakespeare.txt"

dataset = CharDataset(DATA_FILE, BATCH_SIZE, CONTEXT_SIZE)
model = GPT(dataset.vocab_size, CONTEXT_SIZE, EMBEDDING_SIZE, BLOCKS)
loss_fn = GPTLoss()
optimizer = AdamWOptimizer(model.parameters, lr=LEARNING_RATE)
trainer = GPTTrainer(model, loss_fn, optimizer)训练
scheduler = WarmupCosineScheduler(LEARNING_RATE, EPOCHS * len(dataset), 100, LEARNING_RATE / 10)
trainer.train(dataset, EPOCHS, scheduler)评估
prediction, loss = trainer.test(dataset)
print(f'prediction:\t{len(prediction)} steps, each {prediction[0].data.shape}\nloss:\t{loss}')
prediction: 1742 steps, each (4, 32, 65)
loss: 2.872809682593143
推理
print(trainer.generate(dataset, prompt="ROMEO:"))ROMEO:::::M::MM:MMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMMM
本章,我们初步实现了 GPT 模型最核心的机制:自注意力。词元之间终于可以互相看见彼此,每个位置都融合了整个上下文的相关信息。Transformer 模块也从单纯的前馈网络,升级为“注意力 + 前馈网络”的完整结构。
但是推理结果却出人意料,完全失效。这是因为目前的自注意力有一个致命漏洞:每个词元可以看到所有位置,包括它后面的词元。相当于模型在训练时已经偷看答案,在推理时就会露馅。
下一章,我们将探讨怎样堵上这个漏洞。
课后练习
GPT 注意力层的输出投影(
self.output线性层)有什么作用?试试把它去掉,观察训练效果有什么变化?