上一章,我们给 Transformer 模块的两个子层加上了残差连接,从而梯度有了快速通道。但是残差连接也带来一个副作用:每一层的输出都是“输入 + 变换”,随着层数增加,数值不断累积,越来越大,训练变得不稳定。
层归一化
解决办法是层归一化(Layer Normalization):把每一层的输出拉回到均值为 0、方差为 1 的标准分布。
计算均值和方差:
标准化:
缩放和平移:
这里:
:嵌入尺寸;
:一个很小的数(比如 10-5),防止除数为 0;
(weight):可学习的缩放因子(权重);
(bias):可学习的平移因子(偏置)。
不管数值多大,层归一化都可以把数值拉回标准范围,防止数值爆炸。同时使得数值分布稳定,梯度变化更加平滑,收敛更快。
可学习的缩放因子和平移因子使得归一化的幅度可以自动调节,使得一刀切的归一化公式和数据集更加匹配。
import numpy as np

from src.core import *np.random.seed(42)class CharDataset(Dataset):
def __init__(self, filename, batch_size=1, context_size=64, stride=None, split=0.9):
self.filename = filename
self.context_size = context_size
self.stride = stride if stride is not None else context_size // 2
self.split = split
super().__init__(batch_size)
def load(self):
with open(self.filename, encoding="utf-8") as f:
text = f.read()
self.vocab = sorted(set(text))
self.vocab_size = len(self.vocab)
self.stoi = {ch: i for i, ch in enumerate(self.vocab)}
self.itos = {i: ch for i, ch in enumerate(self.vocab)}
self.tokens = self.encode(text)
split = int(len(self.tokens) * self.split)
self.train_data = self._pack(self.tokens[:split])
self.test_data = self._pack(self.tokens[split:])
def _pack(self, tokens):
x, y = [], []
for i in range(0, len(tokens) - self.context_size - 1, self.stride):
x.append(tokens[i: i + self.context_size])
y.append(tokens[i + 1: i + self.context_size + 1])
return x, y
def encode(self, symbols):
return [self.stoi[s] for s in symbols]
def decode(self, tokens):
return "".join(self.itos[t] for t in tokens)下三角矩阵层
class Tril(Layer):

    def __init__(self, value=-1e9):
        super().__init__()
        self.value = value

    def forward(self, x: Tensor):
        keep = np.tril(np.ones(x.shape[-2:]))
        p = Tensor(np.where(keep, x.data, self.value))

        def gradient_fn():
            x.grad += p.grad * keep

return p.attach(gradient_fn, {x})class LayerNorm(Layer):
def __init__(self, normalized_size, eps=1e-5):
super().__init__()
self.eps = eps
self.weight = Tensor(np.ones(normalized_size, dtype=DTYPE))
self.bias = Tensor(np.zeros(normalized_size, dtype=DTYPE))
def forward(self, x: Tensor):
# 均值
mean = np.mean(x.data, axis=-1, keepdims=True)
# 方差
var = np.var(x.data, axis=-1, keepdims=True, ddof=0)
# 标准化
norm = (x.data - mean) / np.sqrt(var + self.eps)
# 创建输出值张量
p = Tensor(self.weight.data * norm + self.bias.data)
# 输出值张量的梯度(闭包)函数
def gradient_fn():
axis = tuple(range(p.grad.ndim - 1)) if p.grad.ndim > 1 else None
self.weight.grad += np.sum(p.grad * norm, axis=axis)
self.bias.grad += np.sum(p.grad, axis=axis)
grad = p.grad * self.weight.data
grad_mean = np.mean(grad, axis=-1, keepdims=True)
norm_mean = np.mean(grad * norm, axis=-1, keepdims=True)
x.grad += (grad - grad_mean - norm * norm_mean) / np.sqrt(var + self.eps)
# 设置输出值张量梯度(闭包)函数和父节点列表
return p.attach(gradient_fn, {x})
# 可训练模型参数列表
@property
def parameters(self):
return [self.weight, self.bias]class GELU(Layer):
def __init__(self):
super().__init__()
self.c = np.sqrt(2.0 / np.pi)
def forward(self, x: Tensor):
tanh = np.tanh(self.c * (x.data + 0.044715 * x.data ** 3))
a = Tensor(0.5 * x.data * (1.0 + tanh))
def gradient_fn():
grad = 0.5 * (1.0 + tanh) + 0.5 * x.data * (1.0 - tanh ** 2) * self.c * (1.0 + 3.0 * 0.044715 * x.data ** 2)
x.grad += a.grad * grad
return a.attach(gradient_fn, parents=[x])class GPTLoss(Loss):
def loss(self, p: Tensor, y: Tensor):
exp = np.exp(p.data - np.max(p.data, axis=-1, keepdims=True))
softmax = exp / np.sum(exp, axis=-1, keepdims=True)
flat_softmax = softmax.reshape(-1, softmax.shape[-1])
flat_y = y.data.reshape(-1).astype(np.int64)
n = len(flat_y)
rows = np.arange(n)
log = np.log(np.clip(flat_softmax[rows, flat_y], 1e-10, 1))
ce = Tensor(0 - np.sum(log) / n)
def gradient_fn():
flat_grad = flat_softmax.copy()
flat_grad[rows, flat_y] -= 1
p.grad += ce.grad * flat_grad.reshape(softmax.shape) / n
return ce.attach(gradient_fn, parents=[p])class GPTEmbedding(Composite):
def __init__(self, vocab_size, context_size, embedding_size):
self.embedding = Embedding(vocab_size, embedding_size)
self.positional_embedding = Embedding(context_size, embedding_size)
super().__init__([self.embedding,
self.positional_embedding])
def forward(self, x: Tensor):
token = self.embedding(x)
position = self.positional_embedding(Tensor(range(x.shape[1])))
return token + positionGPT 注意力层
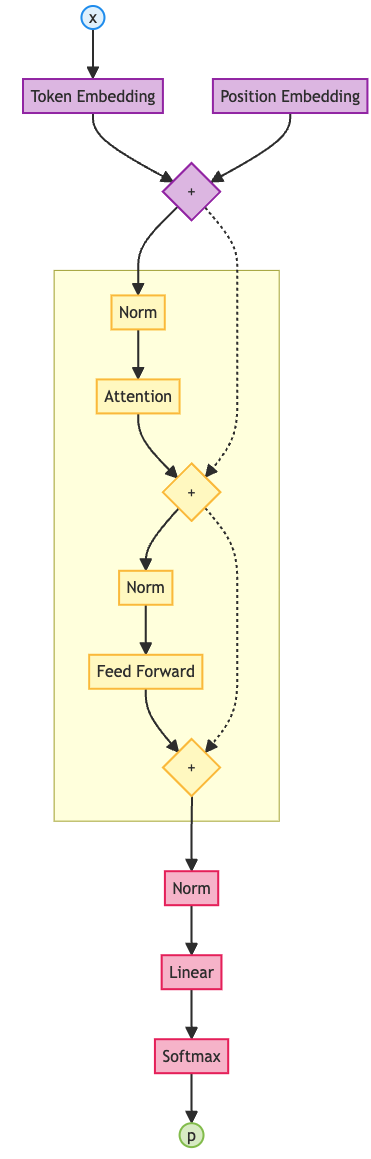
在 GPT 注意力层首先对输入归一化,然后再做注意力,最后残差连接。
class GPTAttention(Composite):

    def __init__(self, embedding_size, heads=1):
        self.embedding_size = embedding_size
        self.heads = heads

        # 归一化层
        self.normalize = LayerNorm(embedding_size)
        self.query = Linear(embedding_size, embedding_size)
        self.key = Linear(embedding_size, embedding_size)
        self.value = Linear(embedding_size, embedding_size)
        self.mask = Tril()
        self.softmax = Softmax()
        self.output = Linear(embedding_size, embedding_size)

        super().__init__([self.normalize,
                          self.query,
                          self.key,
                          self.value,
                          self.mask,
                          self.softmax,
                          self.output])

    def forward(self, x: Tensor):
        # 归一化
        norm = self.normalize(x)
        head_embedding_size = self.embedding_size // self.heads
        multi_head_shape = (-1, x.shape[1], self.heads, head_embedding_size)
        shape = (-1, x.shape[1], self.embedding_size)

        query = self.query(norm).reshape(multi_head_shape).transpose((0, 2, 1, 3))
        key = self.key(norm).reshape(multi_head_shape).transpose((0, 2, 3, 1))
        value = self.value(norm).reshape(multi_head_shape).transpose((0, 2, 1, 3))
        scale = Tensor(np.array(1.0 / np.sqrt(head_embedding_size)))
        scores = query @ key * scale
        weights = self.softmax(self.mask(scores))
        return x + self.output((weights @ value).transpose((0, 2, 1, 3)).reshape(shape))
GPT 前馈网络层
同样,在 GPT 前馈网络层也首先对输入归一化,然后再接前馈网络,最后残差连接。
class GPTFeedForward(Composite):

    def __init__(self, embedding_size):
        # 归一化层
        self.normalize = LayerNorm(embedding_size)
        self.input = Linear(embedding_size, embedding_size * 4)
        self.gelu = GELU()
        self.output = Linear(embedding_size * 4, embedding_size)

        super().__init__([self.normalize,
                          self.input,
                          self.gelu,
                          self.output])

    def forward(self, x: Tensor):
        # 归一化
        norm = self.normalize(x)
        h = self.gelu(self.input(norm))
        return x + self.output(h)
GPT Transformer 模块
class GPTTransformer(Composite):

    def __init__(self, embedding_size, heads):
        self.attention = GPTAttention(embedding_size, heads)
        self.feed_forward = GPTFeedForward(embedding_size)

        super().__init__([self.attention,
                          self.feed_forward])

    def forward(self, x: Tensor):
        x = self.attention(x)
        return self.feed_forward(x)
GPT 输出层
输出层同样首先对输入归一化,确保进入线性层的数据分布稳定。
class GPTOutput(Composite):

    def __init__(self, embedding_size, vocab_size):
        # 归一化层
        self.normalize = LayerNorm(embedding_size)
        self.output = Linear(embedding_size, vocab_size)

        super().__init__([self.normalize,
                          self.output])

    def forward(self, x: Tensor):
        # 归一化
        norm = self.normalize(x)
        return self.output(norm)
GPT 模型
class GPT(Composite):

    def __init__(self, vocab_size, context_size, embedding_size, heads, blocks):
        self.embedding = GPTEmbedding(vocab_size, context_size, embedding_size)
        self.transformers = [GPTTransformer(embedding_size, heads) for _ in range(blocks)]
        self.output = GPTOutput(embedding_size, vocab_size)

        super().__init__([self.embedding] + self.transformers + [self.output])

    def forward(self, x: Tensor):
        x = self.embedding(x)
        for layer in self.transformers:
            x = layer(x)
        return self.output(x)
GPT 训练器
class GPTTrainer(Trainer):

    def train(self, dataset, epochs, scheduler=None):
        dataset.train()
        self.model.train()

        steps = 0
        for epoch in range(epochs):
            for i in range(len(dataset)):
                if scheduler is not None:
                    self.optimizer.lr = scheduler.step(steps)

                feature, label = dataset[i]

                self.optimizer.zero_grad()
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                loss.backward()
                self.optimizer.clip_grad_norm()
                self.optimizer.step()
                steps += 1

    def test(self, dataset):
        dataset.eval()
        self.model.eval()

        predictions = []
        total_loss = 0.0
        with Tensor.no_grad():
            for i in range(len(dataset)):
                feature, label = dataset[i]
                prediction = self.model(feature)
                loss = self.loss_fn(prediction, label)
                predictions.append(prediction)
                total_loss += float(loss.data)

        loss = total_loss / len(dataset)
        dataset.train()
        self.model.train()
        return predictions, loss

    def generate(self, dataset, prompt, steps=256):
        self.model.eval()
        tokens = dataset.encode(prompt)

        with Tensor.no_grad():
            for _ in range(steps):
                feature = Tensor([tokens[-dataset.context_size:]])
                logits = self.model(feature)

                last_logits = logits.data[0, -1]
                exp = np.exp(last_logits - np.max(last_logits))
                probs = exp / np.sum(exp)
                token = np.random.choice(len(probs), p=probs)
                tokens.append(token)

return dataset.decode(tokens)LEARNING_RATE = 0.001批大小
BATCH_SIZE = 4轮数
EPOCHS = 2上下文尺寸
CONTEXT_SIZE = 32嵌入尺寸
EMBEDDING_SIZE = 64头数
HEADS = 2Transformer 模块数
BLOCKS = 2建模
DATA_FILE = "../../../../data/tinyshakespeare.txt"

dataset = CharDataset(DATA_FILE, BATCH_SIZE, CONTEXT_SIZE)
model = GPT(dataset.vocab_size, CONTEXT_SIZE, EMBEDDING_SIZE, HEADS, BLOCKS)
loss_fn = GPTLoss()
optimizer = AdamWOptimizer(model.parameters, lr=LEARNING_RATE)
trainer = GPTTrainer(model, loss_fn, optimizer)训练
scheduler = WarmupCosineScheduler(LEARNING_RATE, EPOCHS * len(dataset), 100, LEARNING_RATE / 10)
trainer.train(dataset, EPOCHS, scheduler)评估
prediction, loss = trainer.test(dataset)
print(f'prediction:\t{len(prediction)} steps, each {prediction[0].data.shape}\nloss:\t{loss}')
prediction: 1742 steps, each (4, 32, 65)
loss: 1.7808665809757263
推理
print(trainer.generate(dataset, prompt="ROMEO:"))ROMEO:
Well.
SABELLA:
Therefore thee go by the tranted is is fastely, and is but more him, where's for you wife?
HORFOMIO:
I am as oncove whomostion on holve all me there and when yalk?
DUKE VINCENTIO:
You speech that be, being suppy,
That try love.
SAVINCO:
本章,我们给 GPT 模型的各模块加装了层归一化,确保残差连接后,进入下一层的数据回到标准范围内,保证训练稳定。
至此,我们基本解决了怎样让 GPT 模型可以堆得更深,同时保证训练稳定的问题,扫除了训练大规模 GPT 模型的发展障碍。下一章,我们将关注大规模训练很容易产生的一个问题:过拟合(Overfitting)。模型在训练集上表现很好,在测试集上却可能很差。模型“记住”了过多的训练数据的细节,而不是真正地“学会”了语言规律。
课后练习
均方根归一化(Root Mean Square Normalization, RMSNorm)是层归一化的一种有效的简化版。RMSNorm 直接假设均值为 0,只计算均方根。并且只保留可学习的缩放因子 ,去掉平移因子 。试试将归一化层改成 RMSNorm,看看训练效果如何?